CMU 15-445 Bustub Project 3 - Query Execution - Note
本文最后更新于 2026年10月18日 下午
前言
不是说和 P1 难度差不多的吗?
前前后后从十月九号写到十月十七号,每天起码 4h+,比较闲就 7~8h+,完成的时候没做任何 Leaderboard 的优化,不过 Leaderboard 排名还不错(24/140+),有点神秘。
和往常一样,开始完全不知道该干什么,写着写着才有点眉目,然后又发现自己之前对于概念的理解完全偏离,推倒重来,如此反复。
主要是这个项目的代码量确实很庞大,需要读的地方很多,架构设计的各种地方,各种数据结构和自定义类型的含义,都需要非常清楚才能写出合适的代码。而且就算很清楚了,最后也不一定写的明白,比如说传 Schema 到底是哪个?的这种问题。
写完了才开始记博客也是有点神秘,应该一边写一边记的。不过,这次我很多东西写在了 commit message 里面,一个 commit message 通常都非常长,也方便我回顾那个时候是如何思考的。
开始不知道该如何做,参考博客:
- CMU15445-2025FALL 个人碎碎念 - W3nYui的文章 - 知乎
- 做个数据库:2022 CMU15-445 Project3 Query Execution - 十一的文章 - 知乎
- BusTub 养成记:从课程项目到 SQL 数据库,这个是本 Project 的作者。
理解核心结构
简单说说吧,因为有点懒得全部记下来,取几个核心要点:
一句 SQL 的执行全流程:上面的三篇博客都有讲到:
-
Parser:借助 PostgreSQL 的第三方解析库,产生 Postgres AST
-
Binder:产生 AST 后,binder 将这个 AST 改写成 bustub 可以理解的,一个更高级的 AST。比如说,
SELECT colA FROM test_1,这就把test_1解析到对应的table_oid上。 -
Planner:其实就是把查询语句里面的信息绑定到各种 plan node 上面。至于什么是 plan node,后面写着写着自然就懂了。然后,构建一颗查询树
-
Optimized:优化 plan node
另外值得一提的是,一般来说:
- Planner 生成的是 Logical Plan Node,代表抽象的 Plan。
- Optimizer 则生成 Physical Plan Node,代表具体执行的 Plan。
一个比较典型的例子是 Join。在 Planner 生成的查询计划中,Join 就是 Join。在 Optimizer 生成的查询计划中,Join 会被优化成具体的 HashJoin 或 NestedIndexJoin 等等。
在 Bustub 中,并不区分 Logical Plan Node 和 Physical Plan Node。Planner 会直接生成 Physical Plan Node。
-
Executor:根据 Planner 的 plan 生成与 plan 对应的 executor,实施具体的执行。
关于 Executor:算子的执行模型也大致分为三种:
- Iterator Model,有 Init 和 Next,但是一个 Next 只返回一个 tuple
- Materialization Model,一次 Next 全量返回(物化)
- Vectorization Model,一次 Next 返回一定数量(自己指定)
Bustub 选用的是第三种。
此外,算子的执行方向也有两种:
- Top-to-Bottom. 从根节点算子开始,不断地 pull 下层算子的数据。
- Bottom-to-Top. 从叶子节点算子开始,向上层算子 push 自己的数据。
Bustub 采用 Top-to-Bottom。
开始前需要了解的大概是这些,那么我们开始正式旅程。当然,如果是初做,听完上面这一大通,想定是摸不着头脑的。还是得具体 dig into code 才能理解。
Task 1
实现三个比较简单的 executor,不过开始不理解概念肯定相当痛苦。
先看这张图片
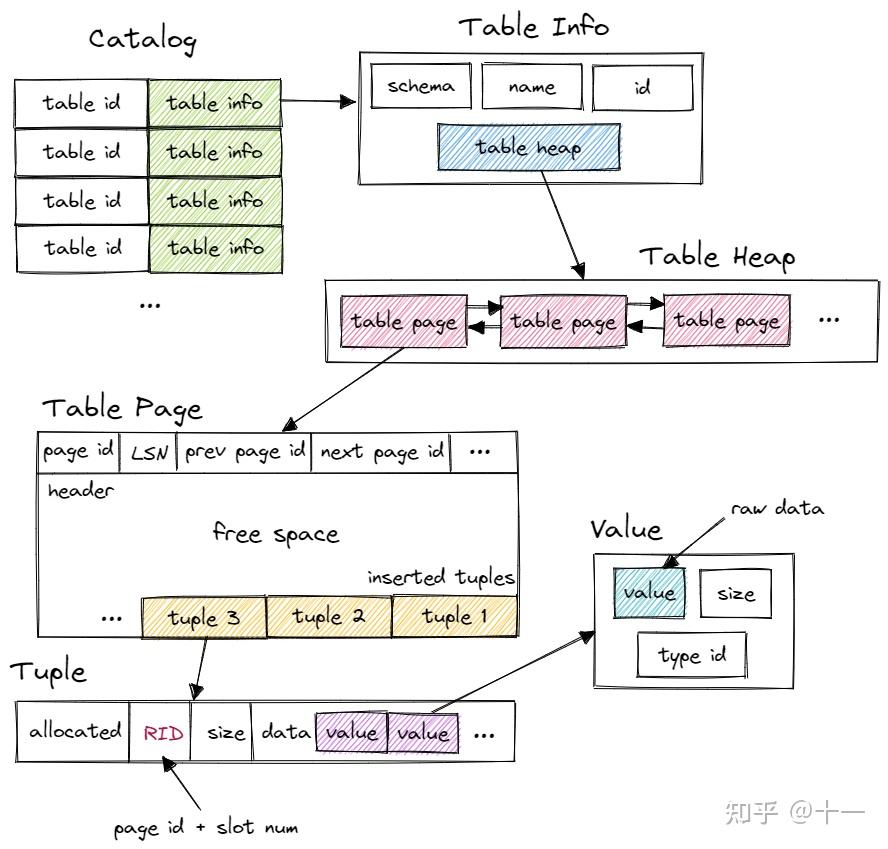
这图还是不错的,理清楚了很多概念。
SeqScan
所以,要实现 SeqScan,就是保存一个 TableHeap 的迭代器,不断读取 Tuple 即可。这样 Next 的状态也得到了维护。记得检查 TupleMeta.is_deleted_。
注意不是从 child executor 里面不断 pull,因为根本就没有 child executor。
Insert 和 Delete
这两个放在一起说,因为大致的框架是一样的:不断从 child executor 拉取 tuple,修改 TableHeap,再维护表上的索引。和 SeqScan 不同,这里是真的有 child executor 的。
不过这里需要注意注释:
@param[out] tuple_batch The tuple batch with one integer indicating the number of rows inserted into the table.
InsertExecutor::Next() returns true with the number of inserted rows produced only once.
比如:
CREATE TABLE t1(id INT, val INT);
INSERT INTO t1 VALUES (1, 10), (2, 20), (3, 30);
child executor 提供的是 (1, 10)、(2, 20)、(3, 30),InsertExecutor 的输出只有一个 tuple,里面只有一个整数 3。Delete 和 Update 也是一样的。
所以我的实现是:
- 在第一次
Next()里面不断调用 child 的Next(),直到把输入全部处理完 - 然后返回一个计数,再用
finished_记录已经执行过 - 后续
Next()读到finished_ == true直接返回false。
最后构造结果的代码,例如 Insert:
tuple_batch->emplace_back(
    std::vector<Value>{ValueFactory::GetIntegerValue(insert_cnt)},
    &GetOutputSchema());
finished_ = true;
return true;
注意:最后即使一行都没有插入,也应该返回一个值为 0 的 tuple。
一些注意事项和踩坑记录
Next() 要清空上一批的输出
贴一条当时的 commit message,add3064:
clear batch before call Next()
check
ExecutionEngine::PollExecutorto understand why!!!
去看 ExecutionEngine::PollExecutor() 就很清楚了:
std::vector<RID> rids{};
std::vector<Tuple> tuples{};
while (executor->Next(&tuples, &rids, BUSTUB_BATCH_SIZE)) {
  if (result_set != nullptr) {
    result_set->insert(result_set->end(), tuples.begin(), tuples.end());
  }
}
调用方会反复使用同两个 vector,不会替 executor 清空。所以 Next() 开头需要:
tuple_batch->clear();
rid_batch->clear();
如果不 clear,那么 SeqScan 的测试会这样:第一批返回 0,第二批变成 0, 1,第三批变成 0, 1, 2,全是重复的旧结果。
Insert:值已经由 child 算好了
06278d7 的 commit message 原文:
insert 是不需要 evaluate 的,这是因为他的 child executor 是 value executor,自带 evaluate(可以看 value executor 的 next 函数)
这里说的是 INSERT ... VALUES ... 的情况。看 ValuesExecutor::Next(),它已经负责逐列求值,再构造 tuple:
const auto &row_expr = plan_->GetValues()[cursor_];
for (const auto &col : row_expr) {
  values.push_back(col->Evaluate(nullptr, dummy_schema_));
}

tuple_batch->emplace_back(values, &GetOutputSchema());
dummy_schema_ 是一个空 Schema。比如 VALUES (1, 10 + 20),这些表达式不依赖某个输入 tuple 的列,所以这里传的是 nullptr 和空 Schema。
当然,Insert 的 child 不一定总是 Values,也可以来自 INSERT INTO ... SELECT ...。但是对于 InsertExecutor,处理方式没有区别:child 返回的已经是求值完成、可以插入表中的 tuple。
因此,主要逻辑就是:
auto table_info = exec_ctx_->GetCatalog()->GetTable(plan_->GetTableOid());
auto indexes = exec_ctx_->GetCatalog()->GetTableIndexes(table_info->name_);

// 下面位于消费 child batch 的循环里面。
std::optional<RID> rid = table_info->table_->InsertTuple({0, false}, tuple);
if (rid.has_value()) {
  for (auto &index_info : indexes) {
    Tuple key = tuple.KeyFromTuple(
        table_info->schema_, index_info->key_schema_,
        index_info->index_->GetKeyAttrs());
    index_info->index_->InsertEntry(key, rid.value(), exec_ctx_->GetTransaction());
  }
  insert_cnt += 1;
}
{0, false} 是 TupleMeta,这里的 false 表示没有被删除。InsertTuple() 返回一个 std::optional<RID>,成功时得到这条新记录在 TableHeap 里的位置。注意这里插入索引用的是这个新 RID,不是 child 返回的 RID,这是因为Values 产生的 tuple 本来就还没有对应的表中位置。
还有一点,更新表不会自动帮我们维护索引。表上有几个索引,就需要分别提取 key,分别插入。
索引的 key 为什么也是一个 Tuple?
这个地方当时也没理解。
比如表的 Schema 是 (id INT, val INT),一行是 (2, 20),索引只建在 id 上:
- 完整 tuple:(2, 20)
- key attrs:[0]
- key schema:(id INT)
- key tuple:(2)
- 索引保存的映射:(2) -> 这一行的 RID
KeyFromTuple() 的三个参数就对应上了:
table_info->schema_:用什么结构读取原来的完整 tuple。index_info->key_schema_:提取出的索引键是什么结构。GetKeyAttrs():从完整 tuple 中取哪些列,以及取出的顺序。
这个 key 虽然类型也叫 Tuple,但里面只有索引需要的列。
其实,我觉得设计成 vector<Value> 是更合理的,不知道为什么是这样的,总之要注意这一点。
Delete:逻辑删除和删除索引项
Delete 的输入是 child 已经筛选出来的待删除记录,拿到 tuple 和对应的 RID,直接删除就行。
不过,虽说是删除,但是这里没有把 tuple 的字节从页面里面抹掉,只是把 TupleMeta.is_deleted_ 设置为 true。然后,删除每个索引中的对应项。
Update
虽然说就是 Insert 和 Delete 拼起来,但是我实际踩的坑比它们加起来还多。Fall 2025 spec 要求先删除旧记录,再插入新记录。
先把 7ed57b8 的 commit message 原封不动贴过来,这一条基本把当时的问题都记下来了:
重构 update_executor,坑很多
一定要去看 plan 和 executor 的字段,别认为都一样。update executor 有
const TableInfo *table_info_,结果我写代码的时候没注意到,所以先定义了个局部变量table_info,然后后面用的时候因为自动补全,用的都是table_info_,结果全是空指针,出错了。。事实上我觉得这个字段也没什么用,局部获得也是一样的。不过既然给了,就在构造函数初始化一下。其次也是另一个字段,但是是 plan node 的
std::vector<AbstractExpressionRef> target_expressions_;。我居然开始没用这个,那我 update 相当于什么也没 update。这里我们需要对这个 vector 逐个 evaluate
- 注意 tidy 需要提前 reserve,禁止 loop 里面 push_back,所以我们可以参考 value_executor 里面的 reserve
然后得到 new_tuple 和 new_rid。然后还要删除旧索引和更新新索引。注意这里索引的 key 很重要。这个 key 的意思就是索引的 key,寻找索引的键。注意就是删除旧索引和建立新索引用的 key 和 rid 都得是对应的那个,不能混用!
target_expressions_ 决定更新后的值
一开始不熟悉 API,做的事情是「把旧 tuple 删除,再把同一个 tuple 插回去」,脱裤子放屁再穿上这一块。
举个例子:
UPDATE t1 SET val = val + 5 WHERE id = 2;假设旧 tuple 是 (2, 20)。Planner 给出的 target_expressions_ 可以理解成一个数组,长度就是最后返回的 tuple 的列数,并且每一列都对应着一个计算,没有被修改的列,Planner 会补上读取旧列的 ColumnValueExpression。:
第 0 列:#0.0        读取旧 tuple 的 id
第 1 列:#0.1 + 5    读取旧 tuple 的 val,再加 5
这里的 #0.1 表示第 0 个输入的第 1 列,下标从 0 开始。
因此,需要逐个 Evaluate(),得到构造新 tuple 的全部 Value:
std::vector<Value> values;
values.reserve(plan_->target_expressions_.size());
for (const auto &expr : plan_->target_expressions_) {
  values.push_back(expr->Evaluate(&old_tuple, child_executor_->GetOutputSchema()));
}
Tuple new_tuple{values, &table_info_->schema_};
得到的就是 (2, 25)。每个表达式都对同一个 old_tuple 求值,不是修改一列之后再拿修改过的 tuple 去算下一列。
到底该传哪个 Schema?
-
当前 executor 的
GetOutputSchema(),代表当前 executor 向父节点输出什么,不是它操作的那张表是什么结构 -
child_executor的 Schema 是同理的 -
plan_->output_schema_和当前的 executor 其实一样,主要是这一行函数都一样:auto GetOutputSchema() const -> const Schema & override { return plan_->OutputSchema(); };
旧 key、旧 RID 和新 key、新 RID
算出新值之后,表上的操作是:
table_info_->table_->UpdateTupleMeta({0, true}, old_rid);
std::optional<RID> new_rid = table_info_->table_->InsertTuple({0, false}, new_tuple);
索引上的操作则要分别提取旧 key 和新 key:
if (new_rid.has_value()) {
  for (auto &index_info : indexes) {
    Tuple old_key = old_tuple.KeyFromTuple(
        table_info_->schema_, index_info->key_schema_,
        index_info->index_->GetKeyAttrs());
    Tuple new_key = new_tuple.KeyFromTuple(
        table_info_->schema_, index_info->key_schema_,
        index_info->index_->GetKeyAttrs());

    index_info->index_->DeleteEntry(old_key, old_rid, exec_ctx_->GetTransaction());
    index_info->index_->InsertEntry(new_key, new_rid.value(), exec_ctx_->GetTransaction());
  }
  updated_cnt += 1;
}
比如索引建在 id 上,旧记录 (2, 20) 位于假设的 RID(10, 0),更新成 (8, 20) 后位于假设的 RID(11, 0),那就是删除 2 -> RID(10, 0),插入 8 -> RID(11, 0)。key 和 RID 都得各自对应,不能把新 key 和旧 RID 拼在一起。
即使只修改 val,id 没变,索引也需要维护。因为 P3 这里是删除再插入,key 可以相同,记录的位置已经换成了新的 RID。原来的索引如果还指向旧记录,查到的就是已经标记删除的那一条。
会不会更新到自己刚插入的记录?
这个问题和 SeqScan 选择哪种迭代器有关: MakeIterator() 和 MakeEagerIterator() 的区别。
例如 UPDATE t1 SET val = val + 1,如果一边扫描一边插入新记录,而迭代器又一直往新的表尾走,就可能把刚插入的记录再更新一遍。这就是这里需要避免的 Halloween problem。
MakeIterator() 创建时会记录当前表尾的停止位置,所以后续扫描不会越过这个边界去追着新插入的记录走。
Optimizing SeqScan to IndexScan
虽然在 spec 上,是顺序是先实现 IndexScan,再是这个优化器。不过 spec 也说先实现后者可以更好地理解前者,所以我就照做,事实也的确如此。
不过既然是第一次遇到优化器,我们首先理解一下优化器的基本结构:
优化器到底在改什么?
The BusTub optimizer is a rule-based optimizer. Most optimizer rules construct optimized plans in a bottom-up way. Because the query plan has this tree structure, before applying the optimizer rules to the current plan node, you want to first recursively apply the rules to its children.
At each plan node, you should determine if the source plan structure matches the one you are trying to optimize, and then check the attributes in that plan to see if it can be optimized into the target optimized plan structure.
In the public BusTub repository, we already provide the implementation of several optimizer rules. Please take a look at them as reference.
优化器接收一棵执行计划树,返回优化后的执行计划树。
写优化器的一个技巧是注意到最后返回的 plan node 到底是什么类型的,然后去看它的构造函数,确定我们需要获得什么东西,然后以此为线索去 coding。
比如,表 t1(id INT, val INT) 的 id 上有索引,查询 WHERE id = 2,可以把计划简化成下面这个变化:
Filter(id = 2)                 SeqScan(filter = id = 2)
  └── SeqScan(t1)       ->              ↓
IndexScan(key = 2)这其实是两条规则:OptimizeMergeFilterScan() 负责把 Filter 合并进 SeqScan,OptimizeSeqScanAsIndexScan() 再尝试替换这个带条件的 SeqScan。
前一条 skeleton code 已经实现好了,后一条才需要我们写。
阅读 OptimizeMergeFilterScan() 的源码,对于实现本题大有好处。
去看 optimizer.cpp 和 optimizer_custom_rules.cpp,里面就是依次调用这些优化函数。顺序是有影响的:我们这条规则读取的是 SeqScanPlanNode::filter_predicate_,前提就是实现好 OptimizeMergeFilterScan()。
然后,几乎每条优化规则开头都有这样一段:
std::vector<AbstractPlanNodeRef> children;
for (const auto &child : plan->GetChildren()) {
  children.emplace_back(OptimizeSeqScanAsIndexScan(child));
}
auto optimized_plan = plan->CloneWithChildren(std::move(children));
就是先递归优化每个 child,再把优化后的 child 装回一个新的当前节点,最后判断当前节点能不能优化。比如根节点是 Projection,下面才是 SeqScan,如果只检查根节点,就永远找不到下面的 SeqScan。
CloneWithChildren() 的含义:保留当前节点的其他信息,只是替换它的 children。相当于保留子树根节点,孩子全部移花接木。
所以 SeqScan 之前也实现错了
因为我们注意到 OptimizeMergeFilterScan() 里面将谓词融进 SeqScanPlanNode 里面,但是我们的 SeqScan Executor 好像根本就没有处理谓词!
这里贴一下 3bf6908 的 commit message 原文:
fully refactor seq_scan_executor
SeqScanExecutor::Next() 有 3 个 Bug。
- 完全没有处理 filter_predicate_:所以 DELETE WHERE id = 1 会删除所有读到的记录。
- 遇到已删除的 Tuple 就直接返回 false:但应该跳过它,继续扫描。
- 每次 Next() 只返回一条 Tuple:没有真正按照 batch_size 批量读取。
主要是最开始做的时候很多概念都没理解,导致这里完全是错误的
第一个坑就和这个优化过程直接相关。Filter 节点已经被合并掉了,判断条件的责任也就交给 SeqScan 了。如果 SeqScan 没处理 filter_predicate_,相当于 WHERE 条件直接没了。
这样处理一下就行:
if (plan_->filter_predicate_ != nullptr &&
    !plan_->filter_predicate_->Evaluate(&tuple, plan_->OutputSchema()).GetAs<bool>()) {
  continue;
}
解析过滤条件的表达式树
这个题的破局之法在于理解清楚 filter_predicate_ 里面的表达式树长什么样。注意它和上面的执行计划树是两回事:
- 执行计划树里面的节点是 SeqScan、Filter、Projection 等算子。
- 表达式树里面的节点是
LogicExpression、ComparisonExpression、ColumnValueExpression等表达式。
比如 WHERE id = 1 OR id = 4 OR 7 = id,一种可能的表达式结构是:
        OR
      /    \
    OR      =
   /  \    / \
  =    =  7   id
 / \  / \
id 1 id 4
所以,对于这里(转化为 IndexScan)spec 里面规定的条件,可以把它理解为:
- 一棵二叉树。
- 把每个比较条件作为整体看,底下都是
ComparisonExpression的=比较。 - 上面是一大堆可能的
LogicExpression,如 spec 所说,只接受or的多条件匹配。 - 比较节点再往下,才是列和常量这两种真正的叶子节点。
所以设计两个处理函数:handle_cmp_expr 处理单个比较条件,handle_expr 递归处理整棵表达式树。
这个写法之后也用到了,很好用。
handle_cmp_expr 需要确认的事情:
- 是不是
ComparisonExpression,并且比较类型是ComparisonType::Equal。 - 一边是不是
ColumnValueExpression,另一边是不是ConstantValueExpression- 这里的逻辑有点烦,因为也可能左边是常量右边是列,所以得反复 if else 确定到底哪个是哪个,所以第一次匹配不上,就交换左右两边再试。
- 对这里支持的整数索引,检查列类型是
INTEGER,常量不是 NULL。
成功时返回列下标和常量表达式,用于交给外部函数构造,失败时返回 std::nullopt。
handle_expr 则检查逻辑节点是不是 OR,再递归检查左右两边:
auto handle_expr = [&](auto &&self, const AbstractExpressionRef &expr) -> bool {
  if (auto logic_expr = dynamic_cast<const LogicExpression *>(expr.get())) {
    if (logic_expr->logic_type_ != LogicType::Or) {
      return false;
    }
    return self(self, logic_expr->GetChildAt(0)) &&
           self(self, logic_expr->GetChildAt(1));
  }
  // 下面调用 handle_cmp_expr,检查并收集单个比较条件。
  // ...
};
这个返回值判断的是「左右两边是否都能解析成我们支持的点查条件」。
还有限制:所有比较必须针对同一列。id = 1 OR val = 4 不优化。
查重和选择索引
WHERE id = 1 OR id = 1 只应该返回一次对应的记录。所以收集常量时用一个 unordered_set<int32_t> 查重,同时用 pred_keys 保存去重后的常量表达式:
if (uset.insert(value).second) {
  pred_keys.push_back(pred_key);
}
insert() 返回值里面的 .second 表示这次有没有真的插入新元素。
重复的值不再加入 pred_keys,但整个条件仍然是合法的,不能因为重复就返回解析失败。后面的 Hash Join 优化器时,这个区别又遇到了一次。
确认整棵表达式都能处理后,再去 Catalog 里面查这张表的索引。我的实现只选择单列整数索引的 OR 条件连接,并要求 GetKeyAttrs().front() 等于刚刚提取出的列下标。找不到就返回原来的计划,找到则构造:
return std::make_shared<IndexScanPlanNode>(
    seq_scan_plan->output_schema_, table_info->oid_, index_oid.value(),
    seq_scan_plan->filter_predicate_, pred_keys);
也就是把输出 Schema、表的 OID、索引的 OID、原来的 predicate,以及要查询的常量都交给 IndexScan。
IndexScan
做好上面的优化器之后其实这个就没什么难的了。
这里没有 child executor,数据来自索引和 TableHeap。注意索引里面找到的是 RID,不是完整的 tuple,拿到 RID 之后还需要回表:
auto [meta, tuple] = table_info->table_->GetTuple(rid);然后和 SeqScan 一样,检查 meta.is_deleted_,跳过已删除的记录,把有效的 tuple 和对应 RID 放进输出 batch。
点查和有序扫描
spec 说需要实现两种查询:
- Point Lookup:
SELECT FROM <table> WHERE <index column> = <val>. You will implement the optimizer rule to transform aSeqScaninto anIndexScanin the next section.- Ordered Scan:
SELECT FROM <table> ORDER BY <index column>. The optimizer rule to generate anIndexScanfor queries withORDER BYon an index column has been implemented for you. Your task is to handleASC(or default) ordering only inIndexScan.
即:
| 查询方式 | 谁生成 IndexScan 计划 | executor 怎么读取 |
|---|---|---|
WHERE id = 1 OR id = 4 |
上面实现的 OptimizeSeqScanAsIndexScan() |
遍历 pred_keys_,逐个调用 ScanKey() |
ORDER BY id ASC,或者省略 ASC |
已有的 OptimizeOrderByAsIndexScan() |
从索引的起始迭代器开始有序遍历 |
这里用 pred_keys_.empty() 区分这两个分支。为空时进行有序扫描,不为空时进行点查。这是当前这些规则生成计划时的约定。
点查先对常量表达式求值,再用索引的 key Schema 构造 key tuple:
const AbstractExpressionRef &expr = plan_->pred_keys_[now_key_idx_];
Value val = expr->Evaluate(nullptr, Schema({}));
Tuple key{{val}, &index_info->key_schema_};

std::vector<RID> rids;
index_info->index_->ScanKey(key, &rids, exec_ctx_->GetTransaction());
if (rids.empty()) {
  continue;
}
RID rid = rids.back();
这里求值的是一个常量,不需要输入 tuple 和 Schema,空参数就行。
构造 key tuple 时则需要真正的 key_schema_,和前面 Insert 提取索引键的道理一样。
有序扫描的部分就是 P2 的迭代器了,B+ 树已经按 key 排好序了,沿着叶子页遍历即可。
这两个分支分别需要保存状态:
- 有序扫描保存
it_,一批满了就停在下一个待处理的索引项。 - 点查保存
now_key_idx_,表示pred_keys_处理到了哪个位置。
[LLM] 明明 spec 允许转换,为什么 dynamic_cast 还是失败?
这里当时还碰到了一个版本问题。我按照 spec 写:
auto tree = dynamic_cast<BPlusTreeIndexForTwoIntegerColumn *>(
    index_info->index_.get());
结果转换出来是空指针。当时我问 Codex 的原话:
第二点我不理解为什么,明明spec说可以自有使用这个转换的
查完才发现,本地代码混进了 Spring 2026 创建索引的改动。单列整数索引实际创建成 GenericKey<4> 的模板实例,而 Fall 2025 这里给的 BPlusTreeIndexForTwoIntegerColumn 用的是 GenericKey<8>,两者是不同的 C++ 类型。
这个名字里面虽然有 TwoIntegerColumn,但不代表我们要查询两个整数列,而是这里固定使用了 8 字节的 key 模板。一个 INT 列只有 4 字节,也可以放在这个 8 字节的 key 里面。dynamic_cast 不会因为它们都叫 B+ 树,就自动在两个不同的模板实例之间转换。
最后只把对应的基础代码和测试回退到 Fall 2025,保留其他实现。b7975d8 的 commit message 原文:
revert(p3): restore Fall 2025 index templates and tests
This reverts commit c26d28cf07acbbdc8b5a46ae6efa1cafb4a7bed2 (s26 p3: added support for composite key indexes in DDL).
Spring 2026 DDL creates
GenericKey<4>indexes for single integer columns, while Fall 2025 specifies BPlusTreeIndexForTwoIntegerColumn, which usesGenericKey<8>. The mismatch makes the prescribed dynamic_cast fail.Restore fixed 8-byte index creation for primary keys and CREATE INDEX, including the original one-or-two-column limit. Remove the Spring 2026 composite-key index scan test and retain the existing Fall 2025 P3 tests.
Validation in Ubuntu with clang 15, using the current working tree:
- sqllogictest builds successfully.
- clang-format and clang-tidy pass for bustub_ddl.cpp.
- P3.01-06: 5/6 pass. P3.05 gets past the original type assertion but still fails on index ordering after UPDATE in the executor implementation.
这里的 5/6 是当时回退后的中间结果,不是后面修改完成后的结果。还有一点,4 字节的列不代表实际一定创建了 4 字节的索引模板,所以也不能只看列的大小就认定是哪一种 C++ 类型。
Task 2
Task 2 包含了 3 个算子,Aggregation、NestedLoopJoin 和 NestedIndexJoin。
Aggregation
Aggregation 的难点在于搞懂一大堆的概念,互相耦合,十分烦人。这里先拿一条 SQL,把输入怎么变成结果的过程串起来。
SELECT department, COUNT(*), SUM(salary)
FROM employee
GROUP BY department;
假设 child executor 依次给出 (CS, 5000)、(Math, 7000)、(CS, 6000),最后应该得到两条结果:CS 有 2 人,工资总和 11000;Math 有 1 人,工资总和 7000。这里是每个组输出一条记录,不是每读一条输入就返回一条。
先读这张图,非常有价值。

先找到分组,再准备这一行的聚合输入
要完成这个查询,需要为每个部门维护一份人数和工资总和。SimpleAggregationHashTable 内部就是一个 unordered_map:key 表示哪个组,value 保存这个组的累计状态。接下来要从每条输入中算出分组 key 和这一行提供的聚合输入,再更新对应组的累计状态。
确定了要按部门统计,先看 Plan 如何描述这件事。里面有三组信息,名字长得很像,但是用途不同:
| Plan 中的方法 | 这个例子里的内容 | 作用 |
|---|---|---|
GetGroupBys() |
department |
计算分组 key,比如 [CS] |
GetAggregates() |
常量 1、salary |
计算每条输入对聚合提供的值,比如 [1, 5000] |
GetAggregateTypes() |
CountStarAggregate、SumAggregate |
决定这两项分别如何累积 |
图里面把第二组简写成了 COUNT(*) 和 SUM(salary),但代码里要再分清楚:表达式负责算出这一行的输入值,聚合类型负责决定怎么累计。比如 SUM(salary) 对应的输入表达式就是读取 salary,不是 Evaluate() 一次就把整个组的 SUM 算出来。
COUNT(*) 则被 Planner 配上了一个常量 1 的输入表达式;具体累积时,CountStarAggregate 每读一行就加一。
然后这两个辅助函数就对应上了:
MakeAggregateKey(&tuple):对group_bys_逐个求值,得到这个 tuple 属于哪个组。MakeAggregateValue(&tuple):对aggregates_逐个求值,得到这一行的聚合输入。
注意,AggregateValue 这个类型既可以表示一行提供的输入值,也可以表示一个组目前累计的结果。类型相同,不代表两者的含义相同。
哈希表保存的就是:
AggregateKey -> AggregateValue
[CS]         -> [2, 11000]
[Math]       -> [1, 7000]
所以哈希表的作用就是快速找到“这个组目前累计到哪里了”。两条 CS 记录虽然在输入中隔着一条 Math,仍然会找到同一个 key,更新同一个条目。这里保存的是每个组的累计状态,不是把所有原始 tuple 按组缓存起来。
如果没有 GROUP BY,MakeAggregateKey() 得到的就是空分组键,所有输入都进入同一个组。也就是说,没有分组列,不代表没有聚合项。
同一个组的结果怎样累计?
有了分组 key 和这一行的输入值,就可以调用 InsertCombine():先在哈希表中找到这个组,不存在就用 GenerateInitialAggregateValue() 创建初值,再调用 CombineAggregateValues() 更新它。
比如 CS 的初值是 [0, NULL]。合并第一条 (CS, 5000),得到 [1, 5000];再合并 (CS, 6000),就得到 [2, 11000]。Math 更新自己的条目,和 CS 分开累计。
CombineAggregateValues() 对每个聚合项,按照 agg_types_[i] 更新 result->aggregates_[i]:
COUNT(*):每一行都加一,不管这一行的其他列是不是 NULL。COUNT(expr):只有输入值不是 NULL 才加一。SUM、MIN、MAX:跳过 NULL;结果还没有有效值时,先接收第一个非 NULL 输入,再进行加法或比较。
比如 SUM 的这一段:
if (!input_val.IsNull()) {
  res_val = res_val.IsNull() ? input_val : res_val.Add(input_val);
}
不能上来就全部用 0 当初值。比如一组工资全是负数,MAX 的初值如果是 0,最后就会凭空算出一个并不存在的最大值。
分组 key 里面也可能有 NULL。这里判断的是“是不是同一组”,两个对应位置都是 NULL 时,应该认为可以放进同一组,所以 AggregateKey::operator==() 里面有这个特殊处理:
if (val.IsNull() && other_val.IsNull()) {
  continue;
}
这和普通 SQL 比较表达式里面的 NULL = NULL 不是同一种判断,不能直接把后者的结果拿来当分组相等关系。
这些步骤连起来之后,构造哈希表时该传什么参数也就清楚了。我最开始却把分组表达式列表传了进去。e75f409 的 commit message 原文:
修正 aggregation executor 构造函数的错误
这里主要是要理清楚 plan 的两个
std::vector<AbstractExpressionRef>之间的区别:
std::vector<AbstractExpressionRef> group_bys_主要是 group by 的字段,比如说 group by salary 那这个 expression 就是 ColumnValueExpressionstd::vector<AbstractExpressionRef> aggregates_这里是具体的聚合计算式,比如 SUM() 什么的这里传入是后者,是因为
- 可能压根没有 group by 的逻辑吧
SimpleAggregationHashTable要求后者,是为了聚合的增量计算;况且,这个的数量对应 Schema 里面要输出的列数,所以遍历的时候也是遍历这个一个一个去算,是合理的。传前者,可能是 0,循环跑都跑不起来
正确的初始化是:
aht_(plan_->GetAggregates(), plan_->GetAggregateTypes())当时第一条 SELECT COUNT(*) ... 就返回了 0,预期却是 8。原因是没有 GROUP BY,GetGroupBys().size() 为 0,而我的 CombineAggregateValues() 又用 agg_exprs_.size() 控制循环,传错了列表,就一次都没有累加。
上面原文说的“对应 Schema 里面要输出的列数”,具体指的是聚合结果的列数,总的输出还要加上分组列。图里的例子是一个分组列、两个聚合列,总共三列。
为什么要先读完输入,再返回结果?
到这里,读一条 tuple 就能更新一次哈希表。但是,当前累计值还不是最终结果。读到第一条 (CS, 5000) 时,后面还可能有 CS 的员工,不能直接把 COUNT = 1, SUM = 5000 返回给上层。
这就是这里的哈希聚合为什么是 pipeline breaker:必须先消费完输入,才能输出最终的分组结果。中间的哈希表保存各组的累计状态,把读取输入和输出结果这两个阶段隔开了。
因此,我把构建阶段放在 Init(),Next() 只负责取结果。Init() 先清空上一次的哈希表,初始化 child,再不断拉取输入:
while (child_executor_->Next(
    &tmp_tuple_batch, &tmp_rid_batch, BUSTUB_BATCH_SIZE)) {
  for (const Tuple &tuple : tmp_tuple_batch) {
    aht_.InsertCombine(
        MakeAggregateKey(&tuple), MakeAggregateValue(&tuple));
  }
}
这里还有一个边界:如果一条输入都没有,循环一次都不会执行,哈希表也就一直为空。但 SELECT COUNT(*) FROM t1 在空输入时,仍然应该返回一行 0。
62d6ad0 的 commit message 原文:
引用
修复一个 edge case
fail 了 test 7,看了一下是一种特殊情况
table 是空表,但是输入
select count(*) from table因为是空表,所以
Init()这里什么也不会插入。但是,实际上我们需要插入初始值。添加了一个插入初始值的函数。但另一个值得注意的是
&& plan_->GetGroupBys().empty()这个附加条件。因为如果只判断 is_table_empty 的话,如果是这样的 SQL
SELECT v1, COUNT(*) FROM t1 GROUP BY v1;因为 v1 是实际出现的,不应该出现,输出就直接应该是什么都没有。如果不加这个条件,输出就会是
NULL 0不符合需求。
反正是个比较刁钻的 edge case,而且涉及到烦人的 NULL,也不用管太多。
所以补的条件是:输入为空,并且没有 GROUP BY。没有 GROUP BY 时,整份输入作为一个组;有 GROUP BY 时,空输入根本没有产生任何组。
if (is_table_empty && plan_->GetGroupBys().empty()) {
  aht_.InsertInitialValue(AggregateKey{});
}
AggregateKey{} 就是空的分组键。注意这里用的是我补的 InsertInitialValue(),只插入初值,不能用 InsertCombine() 假装处理了一行,不然 COUNT(*) 会从 0 加成 1。
另外,也不只处理单独的 COUNT(*):比如 SELECT COUNT(*), SUM(v1) FROM t1,空输入仍需要返回一行初值。按这个 Project 的初值和 p3.07 测试,COUNT(*) 返回 0,其余聚合项返回 integer_null,其中也包括 COUNT(v1)。这里照项目要求处理。
处理完空输入的情况,最后再执行 aht_iterator_ = aht_.Begin(),让输出阶段从最终哈希表的起点开始。每次重新 Init() 都重建这份状态,不能把上一次的聚合结果接着累加。
Next():把每个组的 key 和 value 拼回 tuple
Init() 完成后,每个哈希表条目就是一个组的最终结果。接下来遍历它,每次最多输出 batch_size 条,保存迭代器供下次 Next() 继续。
当时在聊天里面还问过:
这样出来的难道不会是像本来的哈希是 A->(2, 400), B->(3, 600) 然后 values{A, B, 2, 400, 3, 600 }吗?
其实不是把整个哈希表一口气拼进一个 vector。每遍历一个哈希表条目,就新建一个 values,构造一个结果 tuple:
A -> (2, 400)    得到 (A, 2, 400)
B -> (3, 600)    得到 (B, 3, 600)
核心代码就是:
const AggregateKey &key = aht_iterator_.Key();
const AggregateValue &val = aht_iterator_.Val();
std::vector<Value> vals;
vals.insert(vals.end(), key.group_bys_.begin(), key.group_bys_.end());
vals.insert(vals.end(), val.aggregates_.begin(), val.aggregates_.end());
tuple_batch->emplace_back(vals, &GetOutputSchema());
rid_batch->emplace_back(RID{});
++aht_iterator_;
顺序是先分组列,再聚合列。Planner 已经按这个顺序构造了 Aggregation 的输出 Schema,上层再通过 Projection 取 SQL 真正需要的列,不能自己猜一个顺序。
这里生成的是内存中的聚合结果,没有对应的 TableHeap 记录位置。构造 Tuple 也不会自动分配一个物理 RID,我这里给 rid_batch 放的是占位的 RID{}。
另外,HAVING 是上层 Filter 的事情,不用在 AggregationExecutor 里面再实现一遍。
Nested Loop Join
Aggregation 把多条输入累计成每个组的一条结果,Join 则是为一条左表记录寻找满足条件的右表记录。这里需要支持 INNER JOIN 和 LEFT JOIN:INNER JOIN 只输出成功匹配的组合;LEFT JOIN 还要保留完全没有匹配的左行,把右边的列补成 NULL。
算法本身倒是很直接:固定一条左表记录,把右表从头到尾扫一遍;再换下一条左表记录,重新扫描右表。一条左行可能匹配多条右行,每个匹配都要输出。
每次检查一对左右 tuple,用的是 EvaluateJoin(),因为它需要同时知道左右两边的数据和 Schema:
const Value &val = filter_expr->EvaluateJoin(
    &left_tuple, left_schema, &right_tuple, right_schema);
bool has_value = !val.IsNull() && val.GetAs<bool>();
只有结果是非 NULL 的 true 才输出。输出时先拼左表的列,再拼右表的列;LEFT JOIN 没匹配到的那一行,右边则按右表 Schema 的列类型补 NULL。
右表怎样重新扫描?
最开始,我在 Init() 中把整个右表物化到内存,之后每条左行都遍历这份缓存。但这个项目对右侧 executor 的执行方式还有检查,这个实现无法通过测试。6c6df25 的 commit message 原文:
在 Init() 中物化整个右表的实现,无法通过测试
BUSTUB_ASSERT(
    casted_right_executor->GetInitCount() + 1 >=
        casted_left_executor->GetNextCount(),
    "nlj check failed, are you initializing the right executor every time when there is a left tuple? "
    "(off-by-one is okay)");
应该改成我建议改成: 每处理一个新的 left tuple,就通过 right_executor_->Init() 重新扫描右侧,在 Next() 中按 batch 读取右侧 tuple,而不是预先全部缓存。
然后 6509c81 改成了“实现 right table 的部分加载”,为每条新的左行重新开始右侧扫描。
所以这里需要按下面的流程执行:
取一条 left tuple
  -> right executor 从头开始
  -> 一批一批读取 right tuples,逐条检查连接条件
  -> 右表全部结束后,换下一条 left tuple
真正麻烦的是把这个双层循环放进 Next():左表输入、右表输入和输出都有自己的 batch,输出一满就需要暂时返回。下一次调用时,还得知道自己停在哪一条左行、哪一批右表、哪个右行。
两个 cursor 和一个 matched
我这里维护的状态:
| 成员 | 含义 |
|---|---|
left_tuples_、left_cursor_ |
当前左表输入 batch,以及正在处理的那一行 |
right_tuples_、right_cursor_ |
当前右表输入 batch,以及下一个待比较的位置 |
matched_ |
当前左表记录在这轮右表扫描中,是否曾经匹配成功过 |
这里最容易混淆的是三个“结束”:
- 输出 batch 满了:这次先返回,保存所有还没处理完的状态。
- 当前右表 batch 用完了:继续调用右侧的
Next()取下一批,不能立刻换左表记录。 - 整个右表扫完了:右侧
Next()返回 false,这才处理 LEFT JOIN 补 NULL、推进left_cursor_、重置matched_,再通过right_executor_->Init()从头准备下一轮扫描。
右侧成功读到新 batch 时,只需要把 right_cursor_ 重置为 0,当前左行和它的匹配状态都要保留。这个位置弄错了,就会把“一批读完”误当成“整个内表读完”,漏掉后面的结果。
代码里面当时还留了一句注释:
// 上述四个变量的处理位置要深思确实主要难在这些变量到底在哪一个分支重置,而不是 Join 的比较逻辑本身。
matched_ 不能等于“刚才这一对是否匹配”
eb51867 的 commit message 原文:
修正一下循环的时候 matched_ 的逻辑
明确一下语义,意思就是这个内表有被匹配过的一次。之前把 has_value 当 matched 用,结果每次都直接被设置为 true,或者被误搞成 false,完全不合语义。独立出来就好了
开始还想和 index 的那个一样单独再设一个 inner_finished 变量,不过发现没什么必要,现在简单改改就能解决了。
也就是,has_value 只描述当前这一对左右 tuple,matched_ 描述当前左行扫描整个右表时,是否曾经匹配过。两者的生命周期不同。
比如左边是 id = 1,右边依次是 1, 2, 3。第一次成功匹配后,后面虽然都不匹配,也不能再把 matched_ 改回 false,否则最后还会多补一行 NULL。
if (has_value) {
  matched_ = true;
  emit(left_tuple, right_tuple);
}
只有换一条新的左表记录时,才重新设置 matched_ = false。并且这个状态要跨 Next() 保留:第一批已经输出过匹配结果,第二批继续扫描时不能忘记它。
当时 p3.10 和 p3.11 的 LEFT JOIN 多出来 NULL 行,原因就是这里。现在源码把拼接输出提取成了一个 emit lambda:有右 tuple 就拼两边,没有就用 std::nullopt 表示右边补 NULL,省得复制两段几乎一样的构造逻辑。
后面实现 Hash Join 的时候,也是这个问题,而且更加复杂了,光靠维护变量难度太大。所以,写了个类来维护这样的状态,简单很多。当然 NLJ 这里没有实现,可能是因为还不够难 xD
Nested Index Join
实现了前者之后,其实就感觉没那么复杂了。
普通 NLJ 是拿一条外表记录去扫描整个内表,Nested Index Join 则直接拿外表的连接键查内表索引。查到 RID 之后回表,构造连接结果,没匹配到的 LEFT JOIN 仍然补 NULL。
为什么只有一个 child executor?
外表的数据由 child_executor_ 提供,内表则通过 Catalog、索引和 TableHeap 读取,所以这里没有一个 right_executor_ 可以反复 Init()。
以外表当前记录为输入,先计算查索引用的 key:
const Value &outer_val = plan_->KeyPredicate()->Evaluate(
    &outer_tuple, child_executor_->GetOutputSchema());
const Tuple index_probe_key{{outer_val}, &index_info->key_schema_};
index_info->index_->ScanKey(
    index_probe_key, &inner_rids_, exec_ctx_->GetTransaction());
再遍历 inner_rids_,通过内表的 GetTuple(rid) 读取完整记录,跳过 deleted tuple,拼接外表列和内表列。
这里也把几个 Schema 对应一下:
| 使用位置 | 使用的 Schema |
|---|---|
对外表记录计算 KeyPredicate() |
child_executor_->GetOutputSchema() |
| 构造查索引用的 key tuple | index_info->key_schema_ |
| 从内表 tuple 读取列值 | plan_->InnerTableSchema() |
| 构造最后的连接结果 | 当前 executor 的 GetOutputSchema() |
不能因为都是 Tuple,就随便拿一个 Schema 传进去。这里内表没有对应的 child,也就不能从 child 的输出 Schema 获得内表结构。
保存这一次索引查询的进度
NLJ 保存的是右表扫描进度,这里保存的则是当前外表记录查索引得到的 RID 列表,以及这个列表处理到了哪里。把状态的含义分清楚,再写推进和重置的分支:
outer_cursor_:当前处理到外表 batch 的哪一行。inner_cursor_:当前这次查索引得到的 RID 列表处理到了哪里。matched_:当前外表记录是否已经和一条有效的内表记录匹配成功。inner_finished_:当前这次内表候选记录是否已经处理完,需要为下一条外表记录重新查索引。
注意,不能拿整个 tuple_batch 是否为空来判断当前外表记录有没有匹配,它里面可能已经有前几条外表记录的结果。也不能只看 inner_rids_ 是否为空,因为查到了 RID,回表后那条记录仍可能是 deleted。
所以,只有遇到有效的内表记录才把 matched_ 设置为 true。当前 RID 列表全部处理完之后,再决定是否给 LEFT JOIN 补 NULL,然后推进外表 cursor,并把 inner_finished_ 设置为 true。
如果只是输出 batch 满了,而当前 RID 列表还没处理完,就保存 cursor,下次继续;不能直接换下一条外表记录,也不能重复执行同一次 ScanKey()。
最开始我把“是否匹配成功”和“内表是否处理完”混在一起控制流程,还漏掉了 LEFT JOIN。b02f7f5 的 commit message 原文:
修正两个 bug
- matched_ 设置为 true 之后没有恢复 false,逻辑错误,加上去了
- 忘记匹配 left join 了,并且结束匹配的逻辑有点混乱。将「是否成功匹配」和「内表是否扫完」区分开来,这样简化逻辑
另,其实 ScanKey 返回的 RID 是不含重复键的(spec 有说),AI 说了我才意识到。但是我都是按照有重复键的情况写的代码,那也无所谓了。
最后我这里还是按遍历 RID 数组的方式写的。准确说,Fall 2025 这里保证索引键唯一,一次点查至多返回一个 RID,不过不影响继续用这个遍历结构。
第一条外表记录,为什么直接漏掉了?
c7cc8fa 的 commit message 原文:
修改判断逻辑的初始化,保证第一条外表记录去查索引
如果初始化成 false 那么第一次查索引就直接被跳过,后面什么也发生不了了(可以详见注释)
// 可以认为开始内表是不存在(空)的,所以就是「完成了」,所以需要重新生成一个 // 或者这个变量叫 need_new_inner_table 更合适
也就是 Init() 里面必须设置:
inner_finished_ = true;
matched_ = false;
因为查索引的入口是 if (inner_finished_),如果初始值是 false,就会认为已经有一批内表候选记录正在处理,结果第一次根本没有调用 ScanKey()。
这个坑当时在 p3.13 里出现,查询唯一能匹配的恰好就是第一条外表记录,所以结果直接没了。变量名字确实很重要,注释里面说的 need_new_inner_table,比“刚开始什么都没做,为什么是 finished”更容易理解。
最后还有 8d67337,原文就一句:
Next() 忘记清空两个数组了
和前面几个算子一样,Next() 开头清空的是给调用方的 tuple_batch、rid_batch,不是把自己用于继续扫描的外表 batch 和 cursor 一起清空。输出是新的一批,执行状态还得接着上一次往下走。